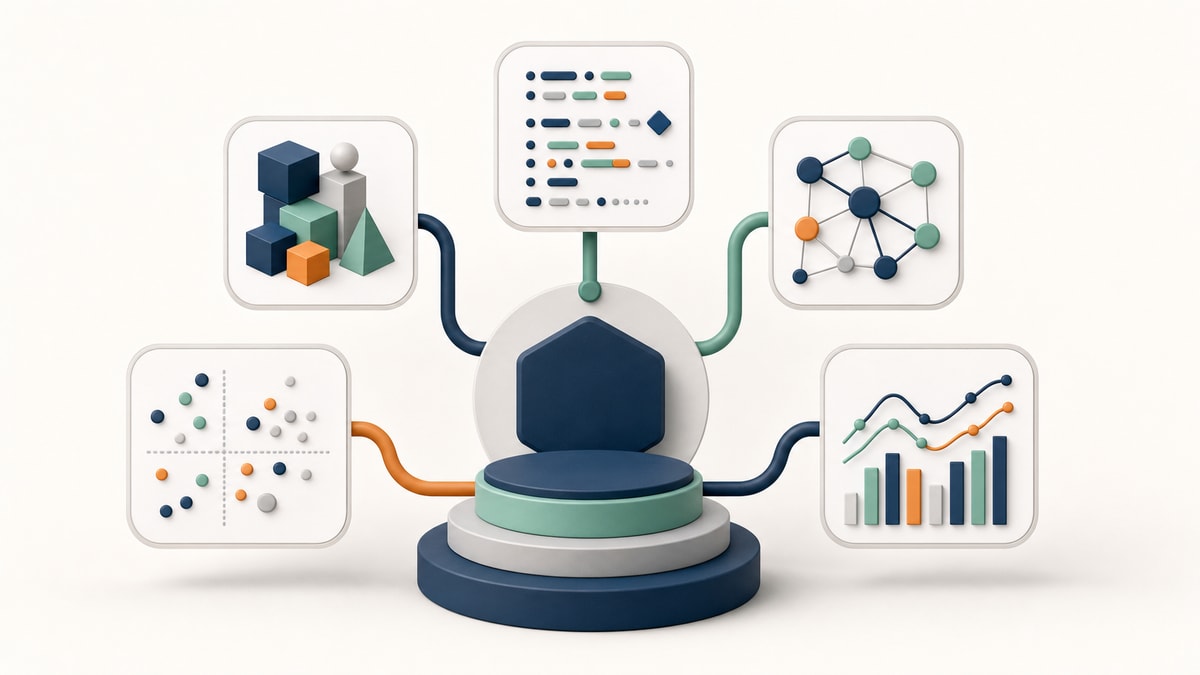
Os algoritmos de Machine Learning podem ser utilizados para prever valores, classificar informações, identificar padrões e agrupar dados.
Entre os modelos que profissionais de dados encontram com frequência estão regressão linear e logística, árvores de decisão, Random Forest, Gradient Boosting, K-Means e SVM.
Para quem deseja trabalhar com IA e dados, entender os algoritmos é importante, mas também é necessário desenvolver conhecimentos em programação, estatística, tratamento de dados e avaliação de modelos.
A expansão da Inteligência Artificial aumentou a presença de modelos de Machine Learning em produtos digitais, sistemas de recomendação, análise de risco, detecção de fraudes, previsão de demanda e diversas outras aplicações.
Para quem está começando na área, porém, uma dúvida costuma aparecer: quais algoritmos de Machine Learning vale a pena aprender primeiro?
A resposta depende do problema que será resolvido. Não existe um único algoritmo adequado para todos os conjuntos de dados. Modelos diferentes atendem a tarefas diferentes, e a escolha também depende de fatores como quantidade de dados, tipo de variável, necessidade de interpretação e desempenho esperado.
Teste vocacional
Qual carreira combina com o seu perfil?
Responda as perguntas e descubra o curso certo e as bolsas ideais para você!
A biblioteca scikit-learn, por exemplo, reúne implementações de algoritmos para classificação, regressão, clustering e outras tarefas de aprendizado de máquina.
Algoritmos de Machine Learning são métodos utilizados para fazer com que um modelo encontre padrões em dados e produza previsões, classificações ou agrupamentos.
Em um problema de aprendizado supervisionado, o modelo recebe dados de treinamento acompanhados dos resultados esperados. É o caso de um sistema que aprende, a partir de registros anteriores, a classificar uma transação como potencialmente fraudulenta.
Já no aprendizado não supervisionado, o conjunto de dados não possui necessariamente uma resposta previamente definida. O algoritmo pode procurar estruturas ou grupos dentro dos próprios dados.
Essa diferença ajuda a entender por que existem diferentes famílias de algoritmos.
A regressão linear é um dos modelos mais conhecidos de Machine Learning e pode ser utilizada quando o objetivo é estimar um valor numérico.
Um exemplo seria prever o preço de um imóvel com base em características como área, localização e número de quartos.
O modelo procura estabelecer uma relação matemática entre as variáveis de entrada e o resultado que se deseja prever.
Onde pode ser aplicada?
Previsão de preços;
estimativa de demanda;
projeção de vendas;
análise de indicadores;
previsão de consumo.
Por ser relativamente simples de interpretar, a regressão linear também é importante para quem está aprendendo os fundamentos de modelos preditivos.
2. Regressão logística
Apesar do nome, a regressão logística é normalmente utilizada para problemas de classificação.
Em vez de prever diretamente um número contínuo, o modelo pode estimar a probabilidade de uma observação pertencer a determinada categoria.
Entre os exemplos estão:
cliente com risco ou sem risco;
e-mail spam ou não spam;
fraude ou operação regular;
aprovação ou reprovação em determinado processo.
Modelos de classificação como regressão logística fazem parte dos algoritmos supervisionados mais utilizados para problemas desse tipo.
3. Árvores de decisão
As árvores de decisão organizam decisões a partir de uma sequência de regras.
Imagine um modelo que precise classificar uma solicitação de crédito. Ele pode analisar variáveis como renda, histórico e valor solicitado e seguir diferentes caminhos até chegar a uma previsão.
Uma vantagem desse tipo de modelo é a facilidade relativa para visualizar a lógica utilizada na tomada de decisão.
Árvores de decisão podem ser utilizadas tanto em classificação quanto em regressão.
4. Random Forest
O Random Forest, ou floresta aleatória, combina diversas árvores de decisão para produzir uma previsão.
Em vez de depender de uma única árvore, o algoritmo trabalha com várias delas e combina seus resultados.
Essa abordagem pode ser utilizada em problemas como:
classificação de clientes;
detecção de padrões;
análise de risco;
previsão de variáveis;
identificação de características relevantes nos dados.
O Random Forest é particularmente importante para quem está estudando Machine Learning porque apresenta aos profissionais um conceito fundamental da área: os métodos de ensemble, nos quais diferentes modelos são combinados para produzir um resultado.
5. Gradient Boosting
O Gradient Boosting também pertence à família dos métodos de ensemble, mas utiliza uma estratégia diferente.
Em termos simplificados, os modelos são construídos de forma sequencial, com os novos modelos procurando melhorar os erros das etapas anteriores.
Essa abordagem deu origem a diferentes implementações e famílias de algoritmos, como Gradient Boosting, XGBoost, LightGBM e CatBoost.
Esses métodos são utilizados principalmente em dados estruturados e podem aparecer em aplicações de previsão, classificação e análise de risco.
Para quem pretende trabalhar profissionalmente com dados, compreender o conceito de boosting é relevante porque ele representa uma evolução importante em relação ao uso de uma única árvore de decisão.
6. K-Means
O K-Means é um dos algoritmos mais conhecidos de clustering, ou agrupamento.
Nesse caso, o objetivo não é necessariamente prever uma resposta conhecida. O algoritmo procura organizar os dados em grupos com características semelhantes.
Um exemplo seria uma empresa analisar seu banco de clientes e identificar grupos com comportamentos parecidos.
O K-Means exige que seja definido previamente o número de grupos desejados. A partir daí, o algoritmo procura distribuir os dados entre os clusters de acordo com a proximidade em relação aos seus centróides. A documentação do scikit-learn aponta o K-Means como um método de uso geral que pode trabalhar com grandes quantidades de amostras.
Exemplos de aplicação
Segmentação de clientes;
agrupamento de produtos;
análise de comportamento;
organização de documentos;
identificação de perfis semelhantes.
7. DBSCAN
O DBSCAN também é utilizado para clustering, mas funciona de maneira diferente do K-Means.
Em vez de exigir previamente uma quantidade de grupos, o método utiliza a densidade dos pontos para identificar agrupamentos. Ele também pode ser útil para identificar observações consideradas outliers.
O scikit-learn apresenta o DBSCAN como uma opção para dados com geometrias não convencionais, diferentes tamanhos de grupos e identificação de pontos fora dos agrupamentos.
Por isso, conhecer mais de um algoritmo de clustering ajuda o profissional a escolher uma abordagem compatível com as características do conjunto de dados.
8. Support Vector Machine (SVM)
O Support Vector Machine (SVM) é um algoritmo utilizado principalmente para classificação, embora também possa ser empregado em regressão.
A ideia central é encontrar uma fronteira capaz de separar diferentes classes de dados.
Em problemas mais complexos, as chamadas funções de kernel permitem trabalhar com relações que não são simplesmente lineares.
O SVM é um dos algoritmos clássicos que continuam fazendo parte do repertório de Machine Learning e aparecem em bibliotecas amplamente utilizadas no desenvolvimento de modelos.
9. Redes neurais
As redes neurais artificiais são modelos inspirados, de maneira abstrata, no funcionamento de redes de neurônios biológicos.
Elas podem ser utilizadas em diferentes tipos de problemas e estão na base de várias aplicações modernas de Inteligência Artificial.
Quando redes neurais possuem muitas camadas, fala-se em Deep Learning.
Entre as aplicações estão:
reconhecimento de imagens;
processamento de linguagem natural;
reconhecimento de voz;
classificação;
previsão;
sistemas generativos.
Para quem está entrando na área de IA, é importante diferenciar o estudo dos algoritmos tradicionais de Machine Learning do universo de Deep Learning. São conhecimentos relacionados, mas envolvem arquiteturas, ferramentas e desafios diferentes.
Comparativo: quais algoritmos de Machine Learning aprender?
Algoritmo
Tipo de problema
Exemplo de aplicação
Regressão linear
Regressão
Previsão de preços
Regressão logística
Classificação
Detecção de fraude
Árvore de decisão
Classificação e regressão
Análise de risco
Random Forest
Classificação e regressão
Previsões com dados estruturados
Gradient Boosting
Classificação e regressão
Modelos preditivos
K-Means
Clustering
Segmentação de clientes
DBSCAN
Clustering
Identificação de grupos e outliers
SVM
Classificação e regressão
Classificação de dados
Redes neurais
Diversos problemas
Imagens, texto e voz
A tabela funciona como um ponto de partida, mas a escolha de um algoritmo em um projeto real depende das características dos dados e do objetivo do modelo.
Como escolher um algoritmo de Machine Learning?
Para quem está começando, decorar uma lista de algoritmos é menos importante do que entender qual problema cada família de modelos resolve.
Uma sequência prática é:
1. Defina o problema
Primeiro, identifique o que o modelo precisa fazer.
Você quer prever um número? Classificar uma informação? Encontrar grupos? Identificar anomalias?
2. Analise os dados
É preciso verificar quantidade de registros, tipos de variáveis, valores ausentes, distribuição dos dados e possíveis outliers.
3. Escolha candidatos
Depois de compreender o problema, alguns algoritmos podem ser selecionados para testes.
4. Treine e avalie os modelos
O modelo precisa ser testado com métricas adequadas ao problema.
Em classificação, por exemplo, podem ser utilizadas métricas como acurácia, precisão, recall e F1-score.
Em regressão, métricas como MAE, MSE e RMSE podem ajudar a avaliar os resultados.
5. Compare os resultados
A escolha não deve considerar apenas a métrica de desempenho. Tempo de processamento, interpretabilidade, custo computacional e facilidade de implantação também podem influenciar a decisão técnica.
Quais algoritmos de Machine Learning um iniciante deve estudar?
Para quem está começando, uma trilha de estudos pode partir dos fundamentos e avançar gradualmente.
Uma possibilidade é:
Regressão linear
Regressão logística
Árvores de decisão
Random Forest
K-Means
SVM
Gradient Boosting
Redes neurais
Deep Learning
O objetivo não deve ser simplesmente conhecer a sintaxe de cada algoritmo. O profissional precisa compreender dados, estatística, programação, treinamento, validação e avaliação de modelos.
Python é uma das linguagens mais utilizadas nesse ecossistema, enquanto bibliotecas como o scikit-learn oferecem ferramentas para trabalhar com diversos algoritmos de aprendizado de máquina.
Machine Learning e mercado de trabalho
O conhecimento de algoritmos é uma parte da formação de um profissional de dados ou IA.
No ambiente profissional, projetos de Machine Learning costumam envolver uma cadeia de atividades que começa antes da escolha do algoritmo:
coleta de dados → tratamento → exploração → preparação → treinamento → avaliação → implantação → monitoramento
Isso significa que saber aplicar um algoritmo isoladamente não é suficiente para desenvolver uma solução de Machine Learning de ponta a ponta.
O profissional também precisa entender conceitos de programação, bancos de dados, estatística, engenharia de software, versionamento e infraestrutura, conforme a função exercida.
Essa visão é especialmente importante para quem está entrando no mercado e deseja transformar o conhecimento teórico em capacidade prática.
Nesse percurso, aprender algoritmos é importante, mas também é necessário compreender como esses modelos são integrados a sistemas reais.
Para profissionais em início de carreira, essa combinação entre fundamentos e aplicação prática pode ajudar a transformar o estudo de conceitos de IA em competências utilizadas no desenvolvimento de projetos.
Quer desenvolver conhecimentos em tecnologia e Inteligência Artificial?
Para quem quer avançar no estudo de Machine Learning, Ciência de Dados e Inteligência Artificial, as trilhas de aprendizagem da Allevo Tech podem fazer parte desse percurso.
A proposta é conectar conhecimentos técnicos com aplicações práticas, permitindo que o profissional avance de fundamentos de tecnologia para competências relacionadas a Engenharia de Software, Ciência de Dados e IA.
Não deixe seu conhecimento ficar no passado, conheça os cursos da Allevo Tech.